Thinking Machines Labが、2026年11月20日に新しいオープンモデル「Inkling 2 Mini」を公開しました。Unslothも同じ日にGGUF版と動かし方のガイドを出しています。
これまでのInklingシリーズは、全体で276Bから975Bある大きなモデルでした。Inkling 2 Miniは26.4Bで、4ビットのGGUFは17.6GBです。一般的なゲーミングPCでも動かせる大きさになりました。
今回はRTX 5060 Ti 16GB、RAM 64GBのWindows PCに、Unslothが配布しているllama.cppのビルドで導入しました。導入の手順と、16GBのGPUで速く動かすための設定、速度、日本語・画像・ツール呼び出しの動作を確認しています。
- Inkling 2 Miniは全体26.4BのMoEモデルです。中間の12層を3回くり返す「ループ型」の構造で、1トークンあたり5.4B相当を計算します。テキストと画像を読めて、ライセンスはApache 2.0です
- 11月21日の時点では、Unslothのllama.cppビルドで動かすのが確実です。本家llama.cppは、正しく動かすための修正が11月21日にマージされたばかりで、記事を書いている時点ではその修正を含むビルドがまだ出ていません
- Unslothが配布するWindows版のビルドにはCUDAのDLLが入っていないため、別に用意する必要がありました
- Unslothのガイドのコマンドには
--n-gpu-layers 99が入っています。そのまま使うと4ビット版が16GBのVRAMに収まりきらず、生成は毎秒5.2トークンでした。このオプションとDSparkの指定を外してllama.cppの自動調整に任せると、毎秒40.8トークンになります - このPCで最も速かったのは、一回り小さいUD-Q3_K_XL(13.6GB)で、毎秒約52トークンでした。下書きモデルで生成を速める「DSpark」は、このPCではかえって遅くなりました
- 日本語の回答、画像の読み取り、ツール呼び出し、約12.5万トークンの中から3つの番号を探すテストは、どれも正しく動きました
Inkling 2 Miniとは
Inklingシリーズの中での位置づけ
Inklingは、Thinking Machines Labが公開しているオープンウェイトのモデルシリーズです。UnslothのInklingのページは、7月に公開された最初の2つのモデルを扱っています。11月に出た2つのモデルには、それぞれ別のガイドがあります。
| モデル | Hugging Faceでの公開 | 全体/アクティブ | UnslothのGGUFの大きさ | 本家llama.cppの対応 |
|---|---|---|---|---|
| Inkling | 2026年7月 | 975B/41B | 1ビット版で約270GB | 未対応(対応のプルリクエストが審査中) |
| Inkling-Small | 2026年7月 | 276B/12B | 74.8GB(UD-IQ1_S)〜163.3GB(UD-Q4_K_XL) | 同上 |
| Inkling 2 Small | 2026年11月 | 594B/17B | 171.7GB(UD-IQ1_S)〜354.2GB(UD-Q4_K_XL) | 対応済み(11月14日) |
| Inkling 2 Mini | 2026年11月20日 | 26.4B/3.4B(ループ込みで5.4B相当) | 7.76GB(UD-IQ1_S)〜17.63GB(UD-Q4_K_XL) | 対応済み(11月20日)。修正が11月21日にマージ |
今回のPCはRAMとVRAMを合わせて80GBです。Inkling-Smallの1ビット版がぎりぎり入るかどうかで、ほかの大きなモデルは収まりません。Inkling 2 Miniなら、4ビット版でもほぼVRAMに載ります。
モデルの特徴
Thinking Machines Labのモデルカードによると、Inkling 2 Miniは次のようなモデルです。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026年11月20日 |
| パラメーター | 全体26.4B、アクティブ3.4B。ループの2回目と3回目で約1.0Bずつ増え、1トークンあたり5.4B相当 |
| 構造 | 24層のデコーダー。中間の12層を同じ重みで3回くり返すため、1トークンにつき48層分を計算します |
| MoE | 各層128個のエキスパートから8個を選びます |
| アテンション | ローカルとグローバルの組み合わせ |
| 入力と出力 | 入力はテキストと画像、出力はテキスト |
| コンテキスト長 | 最大100万トークン |
| 元の重み | NVFP4とMXFP8の混合で約20GB |
| ライセンス | Apache 2.0 |
同じ層を何回も通す「ループ型(Looped Transformer)」は、重みを増やさずに計算量を増やす方法です。Unslothのガイドでは、Inkling 2 Miniはこの仕組みを採り入れた、性能の高いオープンモデルの初期の例と紹介されています。
公式のベンチマーク
モデルカードには同じくらいの大きさのモデルとの比較が載っています。一部を抜き出すと、次のとおりです。数値はThinking Machines Labによるもので、今回は確かめていません。
| ベンチマーク | Inkling 2 Mini | Qwen3.8-27B | Gemma 4 31B |
|---|---|---|---|
| SWE-bench Verified | 79.2% | 77.8% | 46.1% |
| DeepSWE v1.1 | 48.2% | 42.2% | 0.3% |
| SWEBench Pro v2(Hard) | 77.9% | 73.8% | 14.2% |
| Terminal Bench v2.1 | 71.6% | 73.0% | 43.4% |
| BrowseComp | 79.0% | 61.6% | 37.0% |
| MMMU Pro | 74.9% | 76.3% | 73.4% |
| LongBench v2 | 66.9% | 52.3% | 52.9% |
Inkling 2 Miniはコーディングと検索の項目で強く、画像の理解はほかのモデルと同じくらいです。一方でモデルカードは、知識を問う質問では大きいモデルより間違えやすいこと、英語以外では品質が下がる場合があること、推論の強さを最小にしても推論が完全には止まらないことを、制限として挙げています。
UnslothのGGUF
サイズと精度
UnslothのGGUFは10種類あります。Unslothは各ファイルの出力をUD-Q8_K_XLと比べた結果を公開しています。
| 名前 | 大きさ | 平均KLD(UD-Q8_K_XL比) | 最も確率の高いトークンが一致する割合 |
|---|---|---|---|
| UD-IQ1_S | 7.76GB | 0.0911 | 89.4% |
| UD-IQ1_M | 8.02GB | 0.0867 | 90.2% |
| UD-IQ2_XXS | 8.49GB | 0.0726 | 90.6% |
| UD-Q2_K_XL | 9.14GB | 0.0595 | 91.6% |
| UD-IQ3_XXS | 11.66GB | 0.0269 | 94.7% |
| UD-Q3_K_XL | 13.63GB | 0.0174 | 96.3% |
| UD-IQ4_XS | 15.73GB | 0.0109 | 97.7% |
| UD-Q4_K_M | 16.61GB | 0.0108 | 97.9% |
| UD-Q4_K_XL | 17.63GB | 0.0107 | 98.0% |
| UD-Q8_K_XL | 22.87GB | 基準 | - |
UnslothのおすすめはUD-Q4_K_XLです。UD-Q8_K_XLは元のNVFP4のエキスパートをそのまま残したファイルで、Unslothは「フル精度」と呼んでいます。
このほかに、画像を読むための mmproj-F16.gguf(639MB)と、DSpark用の下書きモデル dspark-Inkling-2-Mini-Q8_0.gguf(0.4GB)があります。どちらも使うときだけ読み込む追加ファイルです。
2種類のファイル
配布ページには、同じ中身のGGUFが2組あります。
- ルートにあるファイル:Unsloth独自のループ層の形式です。Unsloth Desktopか、Unslothが配布するllama.cppのビルド(b12588-mix-c0c3de8)で動きます。DSparkも使えます
- Mainline_Supportフォルダーのファイル:本家llama.cppの形式(
inkling2_loop、11月20日に追加)に合わせたファイルです。拡張子が.gguf_fileになっているので、ダウンロード後に.ggufに変えて使います
ただし、本家llama.cppにはループの2回目と3回目でエキスパートの倍率(スケール)が抜け落ちる不具合がありました。UnslothはMainline_SupportのREADMEで、修正(#32704)が入るまでは意味をなさない文字列が出ると注意しています。この修正は11月21日にマージされましたが、記事を書いている11月21日の夜の時点では、本家のリリースビルドが順番待ちで、修正を含むWindows版はまだ出ていません。
そこで今回はルートにあるファイルとUnslothのビルドを使いました。
検証環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti 16GB(ドライバー621.24) |
| CPU | AMD Ryzen 9 9900X(12コア24スレッド) |
| メモリ | DDR5-5600 64GB(32GB×2) |
| ストレージ | NVMe SSD 2TB(PCIe 4.0) |
| OS | Windows 11 Pro |
| llama.cpp | Unsloth版 b12588-mix-c0c3de8(Windows x64、CUDA 12 portable) |
| CUDAのDLL | 本家llama.cpp b12603の cudart-llama-bin-win-cuda-12.4-x64.zip |
| モデル | UD-Q4_K_XL、UD-Q3_K_XL、mmproj-F16、DSpark(Q8_0) |
導入手順(Windows)
PowerShellで、作業用のフォルダーに移動してから順に実行します。以下のコマンドはUnslothのガイドの手順をもとに、このPCで確かめたものです。
1. Unsloth版のllama.cppをダウンロードする
NVIDIAのGPU向けにはCUDA 12版の「portable」を使います。zipは約470MBです。
curl.exe -L -o llama.zip https://github.com/unslothai/llama.cpp/releases/download/b12588-mix-c0c3de8/app-b12588-mix-c0c3de8-windows-x64-cuda12-portable.zip
Expand-Archive llama.zip -DestinationPath llama.cpp
2. CUDAのDLLを追加する
このzipにはCUDAの実行に必要な cudart64_12.dll、cublas64_12.dll、cublasLt64_12.dll が入っていません。このままだと、GPUの一覧が空になります。
PS C:\inkling> .\llama.cpp\llama-server.exe --list-devices
Available devices:
  (none)
Unslothのガイドは先にNVIDIAのCUDA Toolkitを入れるように書いています。今回は本家llama.cppのリリースに付いているDLLのセットを、同じフォルダーに展開しました。
curl.exe -L -o cudart.zip https://github.com/ggml-org/llama.cpp/releases/download/b12603/cudart-llama-bin-win-cuda-12.4-x64.zip
Expand-Archive cudart.zip -DestinationPath llama.cpp
.\llama.cpp\llama-server.exe --list-devices
GPUの名前が表示されれば準備完了です。このDLLはCUDA 12.4のもので、ビルドに使われたCUDA 12.8より古いのですが、今回の検証では問題なく動きました。なお、このzipのDLLにはデジタル署名がありません。気になる場合は、NVIDIAのCUDA Toolkit(12.8以降の12系)を入れる方法を選んでください。このビルドが読み込むのは cudart64_12.dll など名前が _12 のDLLなので、CUDA 13系のToolkitを入れる場合は、Unslothのガイドのとおり、手順1で cuda13-portable のzipを使います。
3. GGUFをダウンロードする
今回のおすすめはUD-Q3_K_XLです(理由は後の計測結果で説明します)。画像を読ませる場合は mmproj-F16.gguf も必要です。
mkdir Inkling-2-Mini-GGUF
curl.exe -L -o Inkling-2-Mini-GGUF/Inkling-2-Mini-UD-Q3_K_XL.gguf https://huggingface.co/unsloth/Inkling-2-Mini-GGUF/resolve/main/Inkling-2-Mini-UD-Q3_K_XL.gguf
curl.exe -L -o Inkling-2-Mini-GGUF/mmproj-F16.gguf https://huggingface.co/unsloth/Inkling-2-Mini-GGUF/resolve/main/mmproj-F16.gguf
UnslothのガイドではPythonの huggingface_hub に付いている hf download コマンドを使っています。どちらで取得しても同じファイルです。
4. llama-serverを起動する
16GBのGPUでは次のコマンドで起動します。Unslothのガイドのコマンドから、--n-gpu-layers 99 とDSparkの指定を外したものです。
.\llama.cpp\llama-server.exe `
    --model Inkling-2-Mini-GGUF/Inkling-2-Mini-UD-Q3_K_XL.gguf `
    --mmproj Inkling-2-Mini-GGUF/mmproj-F16.gguf `
    --jinja --ctx-size 32768 --parallel 1 `
    --temp 1.0 --top-p 1.0 --top-k 0 --min-p 0.0 `
    --host 127.0.0.1 --port 8080
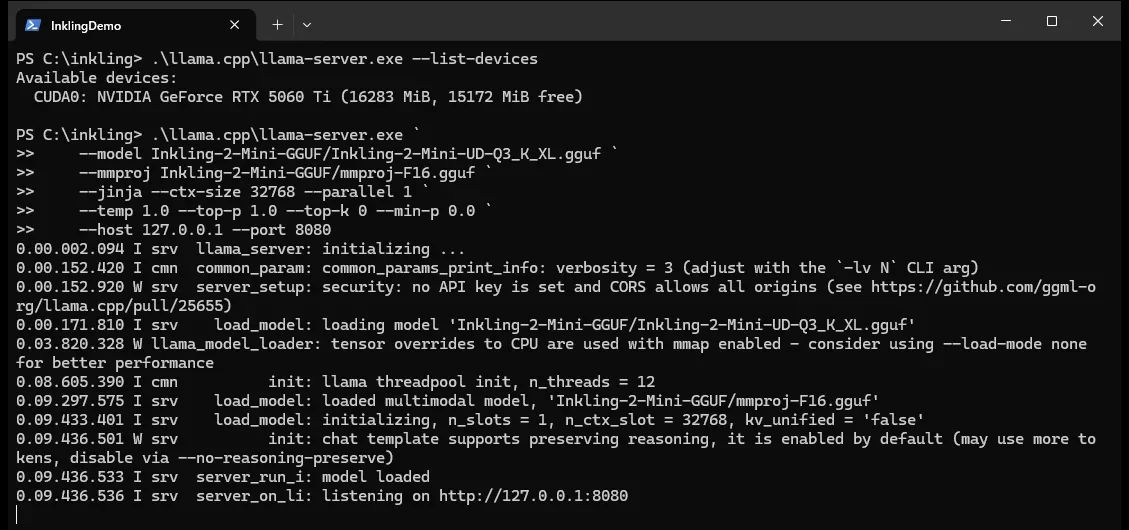
listening on http://127.0.0.1:8080 と表示されれば起動しています。このPCでは、読み込みは10〜25秒ほどでした。サンプリングの設定はUnslothのおすすめ(temperature 1.0、top-p 1.0、top-k 0、min-p 0.0)です。
5. ブラウザーで使う
ブラウザーで http://127.0.0.1:8080 を開くと、llama.cppのチャット画面が使えます。日本語で質問すると、推論(Reasoning)をしてから回答します。
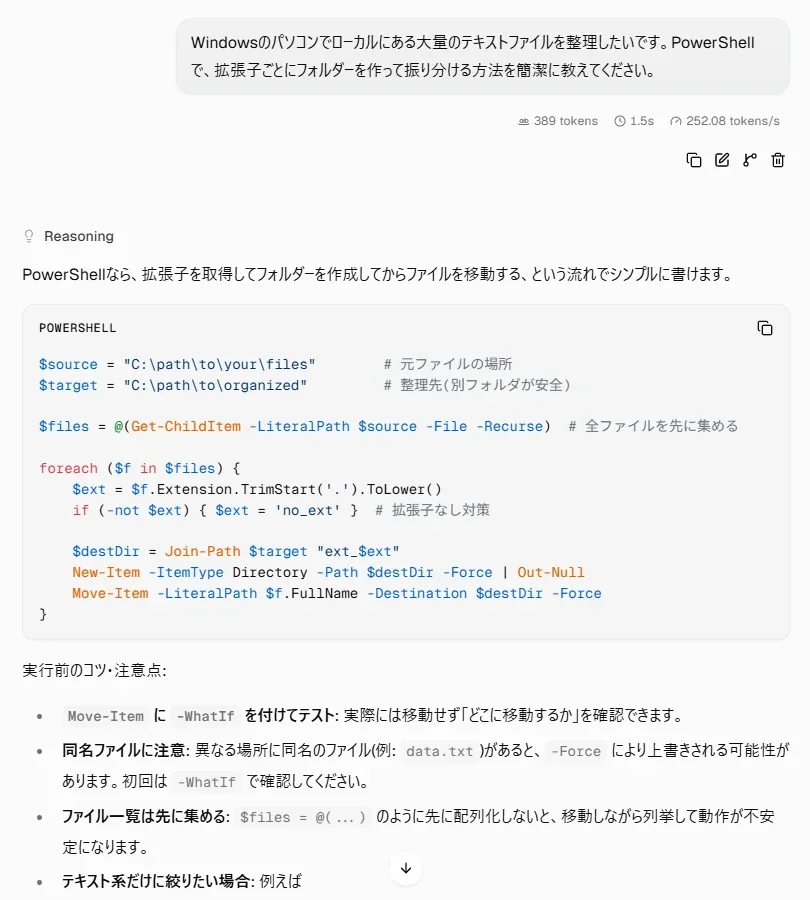
この質問では推論を含めて2,668トークンを毎秒48.5トークンで生成し、55秒で回答が終わりました。推論の中身は日本語の質問でも英語で書かれます。
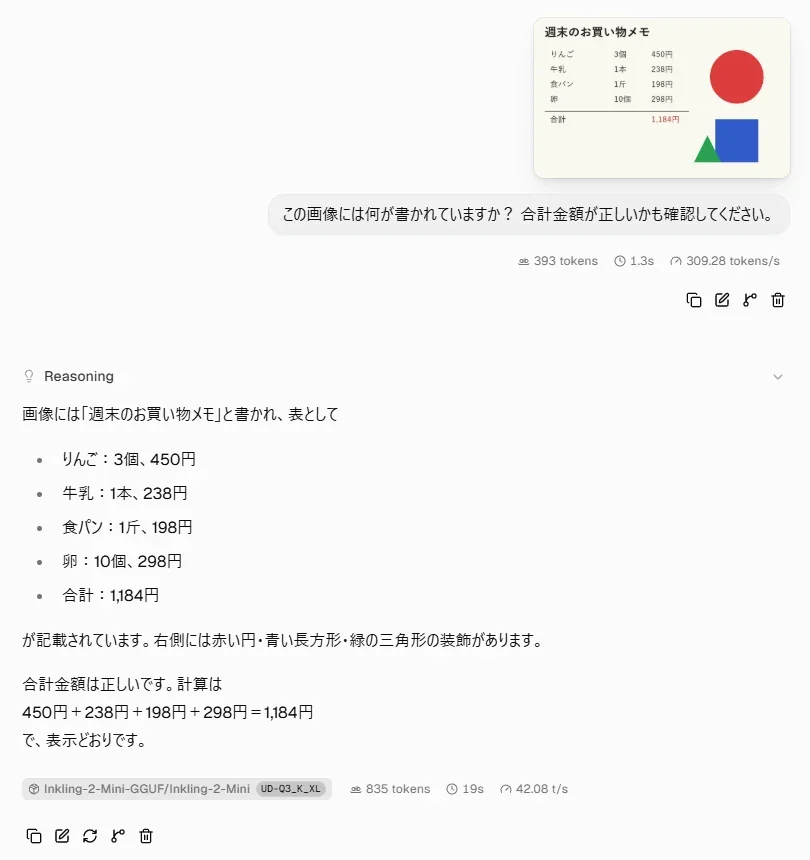
画像は入力欄の「+」から添付できます。買い物メモの画像を読ませると、品名・数量・金額をすべて正しく読み取り、合計金額が合っていることも計算して確かめました。
入力欄の電球のアイコンでは推論の強さを選べます。
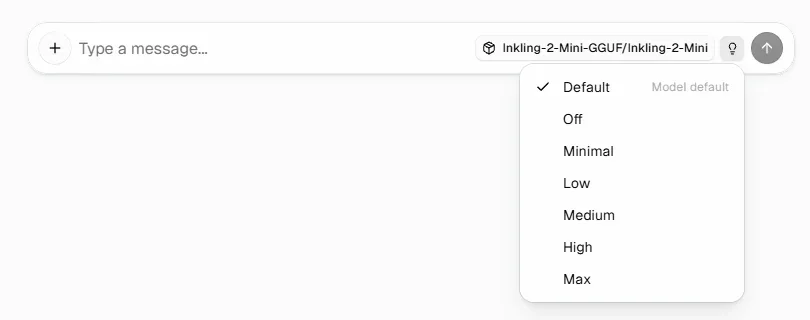
ただし、Inkling 2 Miniでは「Off」を選んでも推論は止まりません。この画面は推論を止める指定(enable_thinking: false)を送りますが、Inkling 2 Miniのチャットテンプレートはこれを読まないためです。17×23を聞いたときも、短い推論を書いてから「391です。」と答えました。
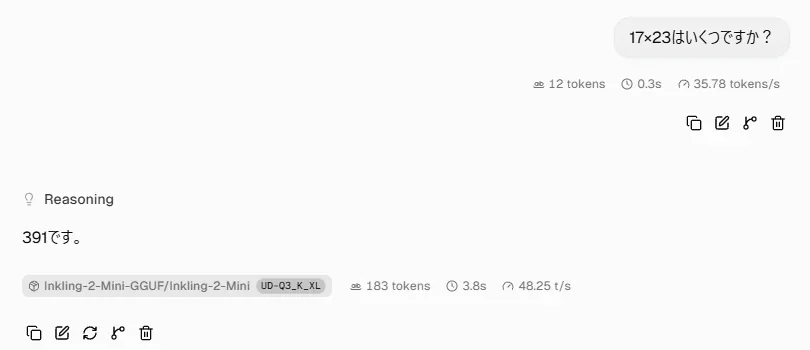
チャットテンプレートが読むのは reasoning_effort です。none、minimal、low、medium、high、xhigh、maxが、0.0〜0.99の「Thinking effort level」に置き換えられてモデルに渡されます。既定値はhigh(0.9)です。noneにしても0.0が渡るだけで、推論は短くなりますが、なくなりはしません。モデルカードにも同じことが書かれています。
llama-serverには推論に使うトークン数の上限を決める --reasoning-budget もあります。--reasoning-budget 0(すぐに推論を終わらせる)も試しましたが、Inkling 2 Miniでは使えませんでした。日本語の短い質問には推論なしで答えたものの、計算問題とツール呼び出しでは、推論を始めては終わる <|message_model|><|content_thinking|><|end_message|> という出力をくり返し、回答がないまま最大トークン数に達しました。
16GBのGPUで気をつけること
Unslothのガイドの起動コマンドは、--n-gpu-layers 99 で全部の層をGPUに置く指定になっています。おすすめのUD-Q4_K_XL(17.63GB)でこのコマンドを使うと、16GBのVRAMには収まりません。llama.cppは起動時に次の警告を出し、メモリに合わせた自動調整をやめてしまいます。
W common_fit_params: failed to fit params to free device memory: n_gpu_layers already set by user to 99, abort
このまま動かすと、VRAMはほぼ満杯(16,311MiBのうち15,787MiB)になります。収まらない分はメインメモリ側に回されたとみられ、チャットの生成は毎秒5.2トークンまで落ちました。
--n-gpu-layers 99 を外すと、llama.cppの自動調整(--fit、既定でオン)が働きます。UD-Q4_K_XLの場合、全部の層をGPUに置いたまま、9つの層のエキスパートの一部をメインメモリに移す配置になり、生成は毎秒28.3トークン(DSparkの指定も外すと毎秒40.8トークン)になりました。同じ理由で、下書きモデルの --n-gpu-layers-draft 99 も外しておくと安全です。
なお、起動時に「--load-mode none のほうが速くなる可能性がある」という警告が出ます。試しましたが、生成速度は変わりませんでした(UD-Q4_K_XLで毎秒40.7トークン、UD-Q3_K_XLで毎秒51.7トークン)。
計測方法
計測にはllama-serverのAPIに要求を送る自作のスクリプトを使いました。数値はllama-serverが返す処理時間(timings)です。
- 推論の強さは
reasoning_effort: "none"にしました。それでも短い推論が入るため、生成したトークン数には推論の分も含まれます - temperatureは0で、各項目は3回の中央値です
- チャット:英語の短い質問を3つ(最大400トークン)
- コード:区間をまとめるPython関数とテストを書かせる(最大900トークン)
- プロンプト:ランダムな単語の列で、約4K・16K・32Kトークンを毎回作り直して読ませる(キャッシュが効かないようにするため)
- コンテキスト長は、断りがなければ32K(32,768トークン)、同時に処理するリクエストは1件です
計測結果
設定ごとの速度
コンテキスト長32Kで比べた結果です。「自動調整」は --n-gpu-layers を指定せず、llama.cppにGPUとメインメモリへの振り分けを任せた場合です。
| モデル | 設定 | DSpark | チャット生成 | コード生成 | 32Kプロンプト |
|---|---|---|---|---|---|
| UD-Q4_K_XL | ガイドのとおり(-ngl 99) |
あり | 5.2トークン/秒 | - | - |
| UD-Q4_K_XL | 自動調整 | あり | 28.3トークン/秒 | 38.3トークン/秒 | 51.8秒 |
| UD-Q4_K_XL | 自動調整 | なし | 40.8トークン/秒 | 41.0トークン/秒 | - |
| UD-Q3_K_XL | 自動調整 | あり | 38.9トークン/秒 | 52.5トークン/秒 | 43.0秒 |
| UD-Q3_K_XL | 自動調整 | なし | 51.9トークン/秒 | 51.4トークン/秒 | - |
| UD-Q3_K_XL | 自動調整、画像なし | なし | 54.2トークン/秒 | 53.9トークン/秒 | 38.7秒 |
- ガイドのとおりの設定は、自動調整でDSparkなしの場合(毎秒40.8トークン)の8分の1ほどの速さでした。この行だけはチャットを1回ずつ測っています
- UD-Q3_K_XL(13.63GB)でも、画像用のmmprojとKVキャッシュを合わせると、16GBにはぎりぎり収まりませんでした。自動調整では、4つの層のエキスパートの一部がメインメモリに移されました。mmprojを読み込まない(画像を使わない)場合は2つの層に減り、少し速くなります
- プロンプトの読み込みは毎秒550〜820トークンでした。32Kトークンを読み終えるまでに、UD-Q3_K_XLで39〜43秒かかります
Unslothの評価では、「最も確率の高いトークンが一致する割合」がUD-Q4_K_XLで98.0%、UD-Q3_K_XLで96.3%です。速さを優先するならUD-Q3_K_XL、精度を優先するならUD-Q4_K_XLになります。
DSparkの効果
DSparkは、小さな下書きモデルが数トークン先を予想し、本体がまとめて確かめることで生成を速める仕組みです。Unslothのガイドの起動コマンドには、最初から入っています。
このPCでは、DSparkを使うとチャットの生成が遅くなりました。UD-Q4_K_XLでは毎秒40.8トークンから28.3トークン、UD-Q3_K_XLでは51.9トークンから38.9トークンです。下書きが採用された割合は、チャットで28〜38%でした。予想が外れる分の計算が、速くなる分を上回っているとみられます。
コードでは採用率が59〜64%に上がり、UD-Q3_K_XLではDSparkありとなしでほぼ同じ速さでした。下書きモデルもVRAMを0.4GBほど使うため、16GBのGPUでは、そのぶん本体のエキスパートがメインメモリに移されます。
128Kコンテキスト
UD-Q3_K_XL(mmprojあり、DSparkなし)で、コンテキスト長を128K(131,072トークン)にして測りました。KVキャッシュが増えるため、自動調整ではメインメモリに移る層が10個に増えています。
| 項目 | 結果 |
|---|---|
| チャット生成 | 36.1トークン/秒 |
| 約6.7万トークンのプロンプト | 106.0秒(毎秒635トークン) |
| 約12.5万トークンのプロンプト | 210.9秒(毎秒598トークン) |
| 約12.5万トークンの中に隠した3つの番号 | 3つとも正解 |
番号のテストでは、ランダムな単語の列の10%、50%、90%の位置に「〇〇の番号は××」という文を入れ、最後に3つの番号を聞きました。回答は「7341, 2958, 6014」で、すべて正しく答えています。
日本語・ツール呼び出し・推論・画像
UD-Q4_K_XLとUD-Q3_K_XLの両方で、次の動作を確かめました。
- 日本語:「ローカルLLMを使う利点を3つ」と聞くと、プライバシー、オフラインで使えること、コストと調整のしやすさを、自然な日本語で3行にまとめました
- ツール呼び出し:天気を調べる関数(get_weather)を渡して「東京の今の天気を調べてください」と聞くと、
{"city":"Tokyo"}を引数にして関数を呼び出しました - 推論の強さ:乗車時間の計算問題(9時40分発、13時05分着、7分の停車が2回)は、lowでもhighでも正しく191分と答えました。この程度の問題では、推論の長さにあまり差は出ませんでした
- 画像:買い物メモの画像(4品目と合計)を、すべて正しく読み取りました。右側の赤い円、青い四角、緑の三角も言い当てています
注意点
- 推論は完全には止められません。
reasoning_effortをnoneにしても、チャット画面でOffを選んでも、短い推論は入ります。すぐに答えだけほしい用途では、そのぶん待ち時間が増えます。--reasoning-budget 0は回答が出なくなるので使わないでください - モデルカードによると、とくにコードのデバッグで、推論が長くループすることがあります。最大トークン数を決めておくのがおすすめです
- ループ型モデルへの対応は新しく、本家llama.cppでは対応が11月20日に、修正が11月21日に入ったばかりです。llama.cppをもとにしたほかのツールで使う場合は、それぞれの対応状況を確認してください。モデルカードも、ローカルでの速度は実行環境やハードウェアによって変わると書いています
- 画像を使わないなら
--mmprojを外すのがおすすめです。VRAMに余裕ができ、UD-Q3_K_XLでは生成が毎秒51.9トークンから54.2トークンに速くなりました
まとめ
Inkling 2 MiniはInklingシリーズで初めて、一般的なGPUで快適に動く大きさのモデルです。RTX 5060 Ti 16GBでは、UD-Q3_K_XLを使い、--n-gpu-layers とDSparkの指定を外してllama.cppの自動調整に任せると、毎秒50トークン前後で動きました。日本語の回答や画像の読み取り、ツール呼び出しも問題ありません。
一方で、Unslothのガイドのコマンドをそのまま16GBのGPUで使うと、大きく遅くなります。--n-gpu-layers 99 とDSparkの指定は外して起動するのがおすすめです。また、CUDAのDLLが入っていない点と、本家llama.cppの修正入りビルドがまだ出ていない点にも気をつけてください。
コメント