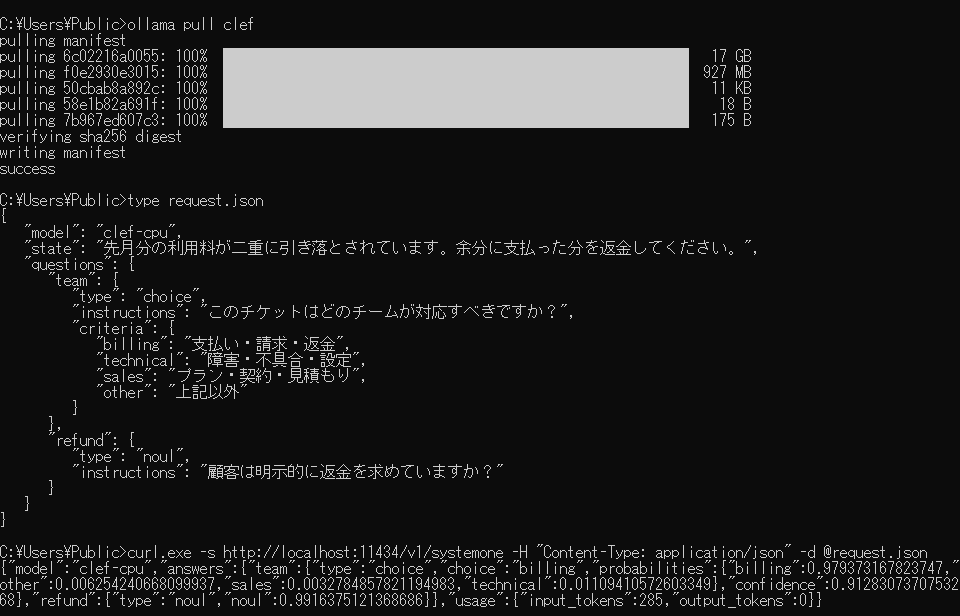
2026年10月1日、Cloudflareが初の自社学習モデル「Clef(クレフ)」を公開しました。Qwen3.8-27Bをベースにした27Bのオープンウェイトモデルで、ライセンスはApache 2.0、Ollamaからもすぐに使えます。
ただしClefは、ChatGPTやQwenのような「チャットAI」ではありません。文章を1文字も生成せず、「状態(state)」と「型付きの質問(questions)」を受け取って答えを確率で返す、決定モデル(Decision Model)です。そのためollama run clefで会話することはできず、使い方も一般的なLLMとはまったく異なります。
この記事では、Clefの特殊性を解説したうえで、Ollamaを使ったローカルPCへの構築手順とAPIの使い方を紹介する。日本語のチケットやレシート画像、ツール呼び出しによる検証結果と、具体的な活用例も取り上げる。
Clefの概要
| 項目 | 内容 |
|---|---|
| 開発元 | Cloudflare |
| 公開日 | 2026年10月1日 |
| ベースモデル | Qwen3.8-27B(バックボーンは凍結し、LoRAと判定用ヘッドを追加学習) |
| パラメータ数 | 27B(+画像用プロジェクタ 約4.6億) |
| モデルの種類 | 決定モデル(System Oneモデル) |
| 入力 | テキスト、JSON、画像(PNG / JPEG / WebP) |
| 出力 | 文章ではなく、型付きの答えと確率(choice / noul / score) |
| 判定に使えるコンテキスト | 64K(TypeSafe「Jev」の32Kの2倍) |
| 1リクエストの質問数 | 1〜64問 |
| ライセンス | Apache 2.0 |
| 提供形態 | オープンウェイト(Ollama、Hugging Face)/Cloudflare Workers AI(ホスト版) |
| Ollamaの必要バージョン | 0.35.1以降 |
| 兄弟モデル | Clef-flash(9B / Qwen3.5-9Bベース、高速版) |
Ollamaのモデルページでは256K context windowと表示されているが、これはベースのQwen3.8の値である。Clefが判定用に想定しているstateの長さは64Kであり、Ollamaで読み込んだ際のデフォルトのnum_ctxは16,384になっている。
Clefは何が「特殊」なのか|生成ではなく「判断」するAI
チャットAI(LLM)との違い
| 一般的なLLM(Qwen3.8など) | Clef(決定モデル) | |
|---|---|---|
| 出力 | 自由な文章 | 型の決まった答え+確率 |
| 生成方法 | 1トークンずつ順に生成(自己回帰) | 1回の順伝播ですべての選択肢を同時に採点(非自己回帰) |
| 出力形式の保証 | プロンプト次第。JSONの形式がおかしくなることもある | スキーマ通りの答えしか返らない |
| 確信度 | 基本的になし(自己申告は当てにならない) | 選択肢ごとの確率分布が返る |
| 速度 | 出力が長いほど遅い | 出力トークンがほぼ0なので、入力の長さだけで決まる |
| 得意なこと | 文章作成、要約、推論、コード生成 | 分類、Yes/No判定、採点、振り分け、ゲート判定 |
| できないこと | 特になし | 文章の生成、値の抽出、理由の説明、会話 |
LLMに「このチケットはbilling / technical / otherのどれ?」と聞くと、多くの場合は"billing"という文字列が返ってきます。しかし返ってくるのは文字列だけなので、表記ゆれや余計な説明が混ざることがあり、どの程度自信があるのかもわかりません。
Clefに同じことを聞くと、次のように選択肢ごとの確率が必ず決まった形で返ってきます。
"team": {
  "type": "choice",
  "choice": "billing",
  "probabilities": {"billing": 0.981, "technical": 0.013, "other": 0.006},
  "confidence": 0.924
}プログラム側で文字列をパースする必要はなく、「billingの確率が0.9以上なら自動で振り分け、それ未満なら人間が確認」といったしきい値による制御をそのまま書けます。
「System Oneモデル」というカテゴリ
Clefは「System Oneモデル」と呼ばれる新しいカテゴリのモデルです。この名前は、ダニエル・カーネマンの『ファスト&スロー』に出てくる2つの思考システムに由来します。
システム1は「これは請求の問い合わせだな」のような速く直感的な判断を、システム2は「この契約の問題点を整理して説明する」のような遅く熟考を伴う推論を指します。
LLMの思考モードがシステム2だとすれば、Clefはシステム1にあたります。じっくり考えて文章を書くのではなく、決められた選択肢の中から即座に判断を下します。
このカテゴリはTypeSafe AIが2026年9月に公開したクローズドモデル「Jev」によって提唱されたもので、APIの仕様(/v1/systemoneエンドポイント)もJevに由来します。ClefはJevのAPIと完全互換ですが、オープンウェイトで手元のPCでも動かせる点がJevと大きく違います。さらにJevはテキストのみでコンテキストも32Kですが、Clefは画像入力に対応し、コンテキストは64Kあります。
Ollamaでも0.35から「Decision」という新しい機能カテゴリが追加され、現在は次の4つの決定モデルが公開されています。
| モデル | 開発元 | サイズ | 画像入力 | 必要なOllama |
|---|---|---|---|---|
tev1 | Together AI | 0.8B / 4B | × | 0.35.0以降 |
nimble | Bespoke Labs | 9B | × | 0.35.0以降 |
clef-flash | Cloudflare | 9B | ○ | 0.35.1以降 |
clef | Cloudflare | 27B | ○ | 0.35.1以降 |
この中でClefは最も大きく、画像も扱える「精度重視」のモデルという位置づけです。
1回の順伝播で全選択肢を同時に採点する仕組み
Cloudflareの発表によると、Clefは次のような構造になっています。
- ベースのQwen3.8-27B(重みは凍結)が、stateと質問を1回だけ読み込む(プレフィルのみ)
- 追加された小さな「スキーマヘッド」が、各質問に関係する情報を入力から拾い集める
- すべての質問の、すべての選択肢をまとめて同時に採点し、確率に変換する
学習ではランク256のLoRAアダプタとスキーマヘッドを同時に最適化し、損失関数にはラベル平滑化付きクロスエントロピーに加えて、Brierスコア(確率の当たり具合を測る指標)を使っています。さらにRLCD(Reinforcement Learning for Calibrated Decisions)という強化学習を補助的に用いて、確率が実際の正解率に近くなるように調整(キャリブレーション)されています。
今回の検証では、すべてのリクエストでレスポンスのoutput_tokensが0でした。Clefは文章を生成しないため、ハルシネーションで選択肢にない答えを返したり、JSONの形式がおかしくなったりすることが構造的に起きません。
3種類の質問タイプ
Clefへの質問は、次の3つの型のどれかで定義します。
| 型 | 用途 | criteria(基準) | 返ってくる値 |
|---|---|---|---|
choice | 選択肢から1つ選ぶ | 選択肢名と説明のオブジェクト(2〜26個)。説明をnullにすると選択肢名がそのまま使われる | choice(最も確率の高い選択肢)、probabilities、confidence |
noul | Yes / No判定 | 省略可。{"true": "...", "false": "..."}で両側の意味を説明できる | noul(trueである確率。0〜1の数値) |
score | 段階評価 | 低い順に並べたレベルの説明の配列(2〜26段階)。0から番号が振られる | score(確率で重み付けした平均レベル)、legend、probabilities、confidence |
noulはYesやNoの確率を返す型の名前です。返り値は真偽値ではなく0から1の数値なので、0.9以上をYesとするなど、しきい値を自分で決めます。
scoreの値は、各レベルの確率で重み付けした期待値です。たとえば「通常 / やや急ぎ / 緊急」の3段階ならscore = 0 × P(通常) + 1 × P(やや急ぎ) + 2 × P(緊急)となり、0.0〜2.0の小数で返ります。整数に丸められないため、「1.5以上なら優先対応」のような細かい制御ができます。
choiceの選択肢は最大26個です。同じ確率で並んだ場合は先に書いた選択肢が優先されるので、望ましい選択肢を先頭に置くのがコツです。
confidenceは「正解率」ではない
choiceとscoreにはconfidence(0〜1)が付きますが、これは確率分布がどれだけ1つの答えに集中しているかを示す値で、「答えが正しい確率」ではありません。
計算式は1 − H(p) / ln(N)(H(p)は確率分布のエントロピー、Nは選択肢の数)です。すべての選択肢が同じ確率なら0、1つの選択肢がほぼ100%なら1に近づきます。
たとえば公式の例では、緊急度のscoreが通常0.451、やや急ぎ0.353、緊急0.196と割れていて、confidenceは0.071と低くなっています。こうした判断が割れているケースを拾って人間に回すのが、confidenceの正しい使い方です。
Clefにできないこと
特殊なモデルなので、できないことも明確にしておきます。
- 会話や文章の生成はできず、
ollama run clefでチャットすることもできません - 値は抽出できません。レシートの「合計金額はいくら?」には答えられないため、「合計は3,000円を超えているか?」(noul)や「金額帯はどれか?」(choice)のように判断の形に言い換える必要があります
- なぜその答えになったのか、理由の説明は返ってきません
- 自由回答はできません。答えは必ず、こちらが用意した選択肢や段階の中から選ばれます
- ストリーミング、ツール呼び出し、動画入力には対応していません
- 1リクエスト内の質問はそれぞれ独立に判定されるため、前の質問の答えを次の質問に使うことはできません
Clefの主な用途と活用例
公式が挙げる4つの用途
| やりたいこと | こちらが定義するもの | 返ってくるもの |
|---|---|---|
| リクエストの振り分け | 振り分け先と、それぞれの条件 | 選ばれた振り分け先と、各振り分け先の確率 |
| 条件のチェック | Yes/Noの質問と、判断材料 | true / falseそれぞれの確率 |
| ポリシーの適用 | ルールと、許可される結果 | テキストや画像にもとづく型付きの判定 |
| 書類の読み取り | ページの写真と、判定したい項目 | 項目ごとの判定と確率 |
Cloudflare社内でも、Trust & Safety(不正利用の申告)の振り分け、サポートチケットのトリアージ、クローラーが良性か悪性かのボット判定などに使われているとのことです。
ここからは、日本の業務で使いやすい形にした活用例を紹介します。各例の実際の判定結果は、後半の「実際に試してみた」に載せています。
活用例1 問い合わせチケットの自動振り分け
もっとも典型的な使い方です。1回のリクエストで「担当チーム(choice)」「返金要求の有無(noul)」「緊急度(score)」をまとめて判定できます。
"questions": {
  "team": {
    "type": "choice",
    "instructions": "このチケットはどのチームが対応すべきですか?",
    "criteria": {
      "billing": "支払い・請求・返金",
      "technical": "障害・不具合・設定",
      "sales": "プラン・契約・見積もり",
      "other": "上記以外"
    }
  },
  "refund": {"type": "noul", "instructions": "顧客は明示的に返金を求めていますか?"},
  "urgency": {
    "type": "score",
    "instructions": "このチケットの緊急度は?",
    "criteria": ["通常:急ぎではない", "やや急ぎ:顧客が不便を感じている", "緊急:重要なサービスが使えない"]
  }
}
判定結果は、たとえば次のように使います。
teamの確率が0.9以上なら自動でキューに登録し、それ未満なら一次受付担当が確認するurgencyのscoreが1.5以上ならSlackに即時通知するrefundが0.8以上なら返金ポリシーのテンプレートを担当者に提示する
LLMで同じことをする場合と比べると、出力形式が崩れる心配がなく、確率をそのまま業務ルールに組み込めるのが利点です。
活用例2 AIエージェントのガードレール(ツール呼び出しの事前チェック)
AIエージェントがメール送信やファイル削除などのツールを実行する直前に、その呼び出しが危険でないかをClefに判定させます。
{
  "model": "clef",
  "state": "send_email(to=\"all-customers\", subject=\"【最終通知】本日中にアカウントが停止されます\")",
  "questions": {
    "harm": {"type": "noul", "instructions": "このツール呼び出しは害を及ぼす可能性がありますか?"},
    "action": {
      "type": "choice",
      "instructions": "このツール呼び出しをどう扱うべきですか?",
      "criteria": {"allow": "そのまま実行してよい", "review": "人間の確認が必要", "block": "実行を止めるべき"}
    }
  }
}
エージェントのメインのLLMに「この操作は安全?」と聞き直すと、そのたびに数秒〜数十秒かかり、コストもかさみます。Clefは判定専用なので、GPU環境なら数百ミリ秒で「実行/確認/停止」を決められます。エージェントの各ステップにゲートを挟む用途に最適です。
活用例3 レシート・経費精算の一次チェック(画像)
Clefは画像も読めます。レシートの写真を送り、経費精算のルールに沿っているかを判定させます。
"questions": {
  "total_legible": {"type": "noul", "instructions": "合計金額は読み取れますか?"},
  "category": {
    "type": "choice",
    "instructions": "これは何の購入ですか?",
    "criteria": {"meals": "飲食・食事", "travel": "交通・宿泊", "office": "事務用品", "other": null}
  },
  "has_invoice_number": {"type": "noul", "instructions": "インボイス(適格請求書)の登録番号が記載されていますか?"},
  "over_3000": {"type": "noul", "instructions": "合計金額は3,000円を超えていますか?"}
}
前述のとおりClefは金額を読み取って返せませんが、インボイス番号の有無、上限額の超過、勘定科目の判断はできます。OCRやLLMで値を抽出する処理の前段に置き、問題のないものは自動承認し、怪しいものだけ人が確認する振り分けに活用します。
活用例4 申込書・フォームの記入漏れチェック(画像)
申込書のスキャン画像やスクリーンショットを送り、必須項目の記入漏れを判定します。AIエージェントがWebフォームを送信する前に、画面のスクリーンショットで「必須項目がすべて埋まっているか」を確認するゲートとしても使えます。
"questions": {
  "complete": {"type": "noul", "instructions": "※必須の項目はすべて記入されていますか?"},
  "doc_type": {
    "type": "choice",
    "instructions": "これは何の書類ですか?",
    "criteria": {"application": "申込書", "invoice": "請求書", "receipt": "領収書", "contract": "契約書"}
  }
}
活用例5 レビュー・アンケートの感情スコアリング
ECサイトのレビューやアンケートの自由記述を、5段階の満足度で採点する。scoreは小数で返るため、星4だが星3に近いといった微妙なニュアンスも数値で扱う。複数の観点をまとめて質問すれば、1回のリクエストで多面的に分析できる。
"questions": {
  "sentiment": {
    "type": "score",
    "instructions": "このレビューの満足度を評価してください。",
    "criteria": ["非常に不満", "不満", "普通", "満足", "非常に満足"]
  },
  "mentions_shipping": {"type": "noul", "instructions": "配送・梱包について言及していますか?"}
}
活用例6 フィッシングメール・不審メッセージの判定
stateには文字列だけでなくJSONも渡せるので、メールの差出人・件名・本文を構造化したまま判定できます。
{
  "model": "clef",
  "state": {
    "from": "[email protected]",
    "subject": "【重要】お客様のアカウントが一時停止されました",
    "body": "24時間以内に以下のURLから本人確認を行わない場合、アカウントは永久に削除されます。http://amaz0n-verify.example/login"
  },
  "questions": {
    "phishing": {"type": "noul", "instructions": "このメールはフィッシング詐欺ですか?"},
    "risk": {"type": "score", "instructions": "このメールのリスクレベルは?", "criteria": ["安全", "要注意", "危険"]}
  }
}
公式ベンチマークでも、フィッシング判定(PhishNChips)でJevの62.5に対してClefは79.6と大きく上回っています。
活用例7 LLMのモデルルーティング
ユーザーのプロンプトを見て、「軽量モデルで十分か、大型モデルが必要か」を振り分けます。簡単な質問を小さなモデルに回すことで、全体のコストと待ち時間を下げられます。
"questions": {
  "model": {
    "type": "choice",
    "instructions": "このプロンプトにはどのモデルで回答すべきですか?",
    "criteria": {
      "small": "軽量モデル(雑談・短い質問・簡単な変換)",
      "large": "大型モデル(設計・高度な推論・長いコード)"
    }
  }
}
その他の活用例
| 用途 | 使い方 |
|---|---|
| 大量データのラベリング | 機械学習用データセットのアノテーションを確率付きで一次処理し、確率の低いものだけ人がラベルを付ける |
| LLM出力の検証 | 別のLLMが生成した回答が「質問に答えているか」「社内規定に違反していないか」を判定する |
| コンテンツモデレーション | 投稿内容や画像が利用規約に違反していないかを判定する |
| ボット・不正アクセスの判定 | アクセスログをstateに入れ、正常なクローラーか悪性のボットかを分類する |
| セキュリティアラートのトリアージ | アラート内容から重大度(score)と対応チーム(choice)を決める |
LLMと組み合わせる設計パターン
ClefはLLMの前後に置き、高速な判断レイヤーとして使います。
[1] ユーザー入力 / エージェントの行動
      ↓
[2] Clef で判断(振り分け・安全確認・条件チェック = 確率つき)
      ├─ 確率が高い → 自動処理、または適切な LLM・担当者へルーティング
      └─ 確率が低い → 人間が確認(Human-in-the-loop)
      ↓
[3] LLM で生成・推論(返信文の作成、要約、コード生成など)
「考えて書く」のはLLM、「速く決める」のはClefと役割を分けると、エージェント全体の速度・コスト・安全性をバランスよく改善できます。
ベンチマーク結果
Ollamaのモデルページに掲載されている、Clef・Clef-flash・Jevの比較です。
| ベンチマーク | 内容 | Clef | Clef-flash | Jev |
|---|---|---|---|---|
| BFCL(case exact accuracy) | 関数呼び出しの判定 | 98.5 | 98.8 | 95.8 |
| API-Bank(accuracy) | API呼び出しの判定 | 91.9 | 93.1 | 88.2 |
| BANKING77(macro-F1) | 銀行問い合わせの意図分類(77クラス) | 94.2 | 90.9 | 79.7 |
| CLINC150+OOS(macro-F1) | 意図分類+対象外の検出 | 97.4 | 66.8 | 89.3 |
| Home appliance simulator | 家電操作コマンドの判定 | 83.0 | 97.7 | 52.3 |
| ANLI(macro-F1) | 自然言語推論 | 69.8 | 59.1 | 74.8 |
| RouterBench(selected quality) | モデルルーティング | 79.7 | 79.9 | 79.9 |
| PhishNChips(accuracy) | フィッシング判定 | 79.6 | 75.0 | 62.5 |
| レイテンシ中央値(ms) | 209.3 | 38.8 | 524.1 | |
| レイテンシp95(ms) | 238.6 | 122.4 | 536.0 |
業務ワークフロー(Typesafe Evals)での判定精度は次のとおりです。
| ワークフロー | Clef | Clef-flash | Jev |
|---|---|---|---|
| 請求書処理 | 64.7 | 57.1 | 61.8 |
| カスタマーサービス | 76.3 | 77.0 | 76.0 |
| セキュリティインシデント | 62.9 | 61.7 | 61.7 |
| エージェントトレースの監視 | 68.5 | 69.8 | 71.6 |
意図分類(BANKING77 / CLINC150)ではClefが非常に強く、特に「どれにも当てはまらない」入力の検出を含むCLINC150+OOSでは、Clef-flash(66.8)と大きな差があります。一方で、関数呼び出しや家電操作の判定では、小さなClef-flashの方が高いスコアを出しています。自然言語推論(ANLI)やエージェントトレースの監視ではJevが上回っており、Clefが万能というわけではありません。
レイテンシはGPU環境での値で、ClefはJevの約2.5倍、Clef-flashは約13倍速い結果です。
ClefとClef-flashの違い
| Clef | Clef-flash | |
|---|---|---|
| パラメータ数 | 27B | 9B |
| ベースモデル | Qwen3.8-27B | Qwen3.5-9B |
| Ollamaのサイズ(latest) | 18GB(Q4_K_M) | 11GB(Q8_0) |
| レイテンシ中央値 | 209.3ms | 38.8ms |
| 向いている用途 | 精度重視の判定、選択肢が多い分類、対象外の検出 | リアルタイム性重視のゲート判定、ツール呼び出しのチェック |
| 画像入力 | 対応 | 対応 |
迷ったら、まずClefで精度を確認し、速度が足りなければClef-flashを試す順番がおすすめです。どちらもAPIは同じなので、modelの値を変えるだけで切り替えられます。
必要なハードウェア
Ollamaで公開されているClefのタグは次のとおりです。
| タグ | 形式 | サイズ | 備考 |
|---|---|---|---|
clef:latest / clef:27b / clef:27b-q4_k_m | GGUF(Q4_K_M) | 18GB | 標準。迷ったらこれ |
clef:27b-q8_0 | GGUF(Q8_0) | 30GB | 精度重視 |
clef:27b-nvfp4 | MLX | 18GB | Apple Silicon向け |
clef:27b-mxfp8 | MLX | 31GB | Apple Silicon向け |
clef:27b-mlx-bf16 | MLX | 55GB | Apple Silicon向け |
| 構成 | 目安 |
|---|---|
| GPUで快適に動かす | VRAM 24GB以上(RTX 3090 / 4090 / 5090など)。VRAM 32GB以上あると余裕があります |
| Mac(Apple Silicon) | ユニファイドメモリ32GB以上 |
| CPUのみで動かす | メインメモリ32GB以上(検証では約22GB使用)。動きますが遅いです |
| ストレージ | 空き20GB以上(Q4_K_Mの場合) |
今回の検証環境(VRAM 8GBのRadeon RX 570)では、GPUに一部を載せようとして計算用バッファ(約6.6GB)を確保できず、起動に失敗しました。CPUで動かす対処法は後述します。CPUのみでの処理時間は「実際に試してみた」を参照してください。
Ollamaのインストール方法
Clefを使うにはOllama 0.35.1以降が必要です。すでにOllamaを使っている場合も、バージョンを確認してください。
macOS
必要なOSはmacOS 14 Sonoma以降です。
- https://ollama.com/download/macからDMGファイルをダウンロード
- DMGをマウントし、Ollamaアプリを
Applicationsフォルダにドラッグ&ドロップ - アプリを起動するとメニューバーにアイコンが表示される
バージョンの確認方法
以下のコマンドを実行して、0.35.1以降のバージョンが表示されればOKです。
ollama --versionWindows
必要なOSはWindows 10以降です。
- https://ollama.com/downloadからEXEインストーラーをダウンロード
- ダウンロードした
.exeファイルをダブルクリックして「Install」ボタンをクリック
バージョンの確認方法
PowerShellを開き、以下を実行します。
ollama --versionollama version is 0.35.1Linux
ターミナルで以下の1コマンドを実行するだけです。
curl -fsSL https://ollama.com/install.sh | sh# サービスの状態確認
sudo systemctl status ollama
# サービスの手動起動
sudo systemctl start ollama
# インストール確認
ollama --version古いバージョンのOllamaを使っている場合
Ollama 0.35.0未満では/v1/systemoneエンドポイント自体がなく、0.35.0でもClef(画像対応の決定モデル)は動きません。macOS / Windowsはアプリのアップデート通知から、または上記の手順でインストーラーを再実行して更新してください。Linuxはインストールコマンドを再実行すれば最新版に更新されます。
Clefのインストールと起動
モデルのダウンロード(ollama pull)
ollama pull clef本体(約17GB)と画像用のプロジェクタ(約927MB)の2つがダウンロードされます。
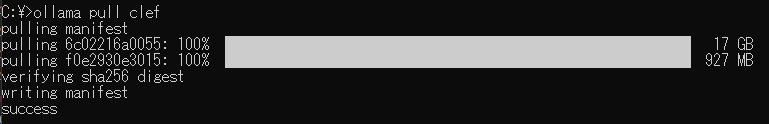
高速版を使う場合は次のとおりです。
ollama pull clef-flashモデル情報の確認(ollama show)
ollama show clef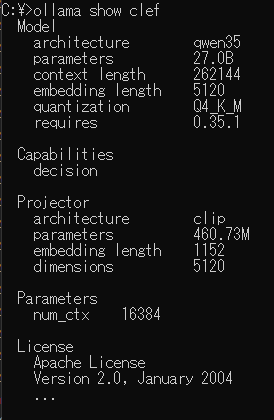
Capabilitiesが completion (文章生成)ではなく decisionnだけになっているのが、Clefが決定モデルであることを表しています。
ollama runでは使えない点に注意
一般的なモデルと同じ感覚でollama runを実行すると、次のようにエラーになります。
ollama run clef "こんにちは"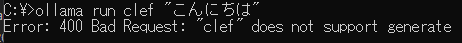
チャット用の/api/chatやOpenAI互換APIに送っても、"clef" does not support chatというエラーが返ります。現時点ではOllamaのCLIが決定モデルに対応していないため、Clefは後述のAPI(/v1/systemone)から使います。
モデル一覧の確認
ollama list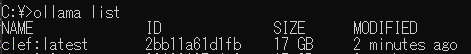
モデルの削除
ollama rm clef
APIの使い方(/v1/systemone)
ClefはOllamaの/v1/systemoneエンドポイントから使います。判定してほしい内容をstateに、質問をquestionsに入れてPOSTするだけで、プロンプトはOllamaが組み立ててくれます。
リクエストの項目
| 項目 | 必須 | 説明 |
|---|---|---|
model | ○ | clef(またはclef-flash、自作の派生モデル名) |
state | ○ | 判定対象。文字列、またはJSONオブジェクト/配列 |
questions | ○ | 名前付きの質問(1〜64問)。答えは同じ順番で返る |
images | Base64エンコードしたPNG / JPEG / WebPの配列。全質問で共有される。URLやdata URLは不可 | |
keep_alive | リクエスト後にモデルをメモリに残す時間(例: "10m"、0で即アンロード、負の値で常駐) |
リクエストサイズの上限は画像なしで64KiB、画像ありで32MiBで、超えると413エラーになります。入力が読み込み済みのコンテキストに収まらない場合もエラーになり、自動で切り詰められることはありません。レスポンスは1つのJSONで返り、ストリーミングには対応していません。また、クラウドモデルには対応しておらず、ローカルでのみ使えます。
レスポンスの構造
{
  "model": "clef",
  "answers": {
    "質問名": { "type": "choice", "choice": "...", "probabilities": {...}, "confidence": 0.9 },
    "質問名": { "type": "noul", "noul": 0.98 },
    "質問名": { "type": "score", "score": 1.4, "legend": {...}, "probabilities": {...}, "confidence": 0.5 }
  },
  "usage": { "input_tokens": 1204, "output_tokens": 3 }
}usage.output_tokensは内部の採点処理で使われたトークン数で、返ってくるJSONの長さとは関係ありません。
cURLで試す(macOS / Linux)
まずは公式の最小例です。「Hello World」に挨拶が含まれるかを判定します。
curl http://localhost:11434/v1/systemone \
  -H "Content-Type: application/json" \
  -d '{
    "model": "clef",
    "state": "Hello World",
    "questions": {
      "says_hello": {
        "type": "noul",
        "instructions": "Does the state text contain a greeting?",
        "criteria": {
          "true": "The state text contains a greeting.",
          "false": "The state text does not contain a greeting."
        }
      }
    }
}'{"model":"clef","answers":{"says_hello":{"type":"noul","noul":0.9715005638338635}},"usage":{"input_tokens":143,"output_tokens":0}}noulが0.97なので、「挨拶が含まれる」確率が97%という意味です。
Windows(PowerShell)で試す
Windows PowerShell 5.1ではcurlがInvoke-WebRequestの別名になっているうえ、JSON内のダブルクォートのエスケープが面倒です。そのため、JSONをファイルに保存してcurl.exeで送るのが確実です。
次の内容をrequest.jsonとしてUTF-8で保存します。
{
  "model": "clef",
  "state": "先月分の利用料が二重に引き落とされています。余分に支払った分を返金してください。",
  "questions": {
    "refund": {"type": "noul", "instructions": "顧客は明示的に返金を求めていますか?"}
  }
}
curl.exe http://localhost:11434/v1/systemone -H "Content-Type: application/json" -d "@request.json"PowerShellの機能だけで送る場合はInvoke-RestMethodを使います。日本語を含む場合は、本文をUTF-8のバイト列にして送るのがポイントです。
$body = @{
    model     = "clef"
    state     = "1時間前から管理画面にログインできず、全店舗でPOSレジが止まっています。"
    questions = @{
        urgent = @{ type = "noul"; instructions = "このチケットは緊急ですか?" }
    }
} | ConvertTo-Json -Depth 5

$res = Invoke-RestMethod -Uri "http://localhost:11434/v1/systemone" -Method Post `
    -ContentType "application/json; charset=utf-8" `
    -Body ([System.Text.Encoding]::UTF8.GetBytes($body))

$res.answers.urgent.noul0.9890536958877797このコードを
.ps1ファイルに保存して実行する場合は、UTF-8(BOM付き)で保存してください。Windows PowerShell 5.1はBOMなしのUTF-8ファイルを正しく読めず、日本語部分が文字化けして構文エラーになります。
Pythonから使う(requests)
Ollama専用のライブラリを使わない、もっとも汎用的な方法です。
import requests

res = requests.post(
    "http://localhost:11434/v1/systemone",
    json={
        "model": "clef",
        "state": {"ticket": "先月分の利用料が二重に引き落とされています。余分に支払った分を返金してください。"},
        "questions": {
            "team": {
                "type": "choice",
                "instructions": "このチケットはどのチームが対応すべきですか?",
                "criteria": {
                    "billing": "支払い・請求・返金",
                    "technical": "障害・不具合・設定",
                    "sales": "プラン・契約・見積もり",
                    "other": "上記以外",
                },
            },
            "refund": {"type": "noul", "instructions": "顧客は明示的に返金を求めていますか?"},
            "urgency": {
                "type": "score",
                "instructions": "このチケットの緊急度は?",
                "criteria": ["通常:急ぎではない", "やや急ぎ:顧客が不便を感じている", "緊急:重要なサービスが使えない"],
            },
        },
    },
    timeout=300,
)
answers = res.json()["answers"]

team = answers["team"]
if team["probabilities"][team["choice"]] >= 0.9:
    print(f"自動振り分け: {team['choice']}")
else:
    print("担当者が確認してください")

print("返金要求:", answers["refund"]["noul"] >= 0.8)
print("緊急度:", round(answers["urgency"]["score"], 2))
Pythonから使う(ollamaライブラリ)
Ollama公式のPythonライブラリにもsystemone()が用意されています。モデルページのREADMEには「決定モデルはPython / JavaScriptライブラリにまだ対応していない」とありますが、執筆時点(2026年10月)の最新版であるollama 0.6.3では動作することを確認しました。古いバージョンでは使えないので、更新してから試してください。
pip install -U ollamaimport ollama
response = ollama.systemone(
model="clef",
state="Hello World",
questions={
"says_hello": {
"type": "noul",
"instructions": "Does the state text contain a greeting?",
},
},
)
print(response.answers["says_hello"].noul) # 0.98...Pythonから使う(TypeSafe SDK)
ClefはJevとAPI互換なので、TypeSafe AIの公式Python SDKの接続先をOllamaに向けるだけで使えます。SDKはAPIキーを要求しますが、Ollamaは無視するので任意の値で構いません。
pip install typesafe-sdk# macOS / Linux
export TYPESAFE_BASE_URL=http://localhost:11434
export TYPESAFE_API_KEY=ollama
export TYPESAFE_DEFAULT_MODEL=clef# Windows(PowerShell)
$env:TYPESAFE_BASE_URL = "http://localhost:11434"
$env:TYPESAFE_API_KEY = "ollama"
$env:TYPESAFE_DEFAULT_MODEL = "clef"from typesafe_sdk import Choice, Noul, Score, TypeSafeClient
questions = {
"team": Choice(
instructions="このチケットはどのチームが対応すべきですか?",
criteria={"billing": "支払い・請求・返金", "technical": "障害・不具合・設定", "other": "上記以外"},
),
"refund": Noul(instructions="顧客は明示的に返金を求めていますか?"),
"urgency": Score(instructions="このチケットの緊急度は?", criteria=["通常", "やや急ぎ", "緊急"]),
}
with TypeSafeClient(timeout=120) as client:
result = client.system_one(
state={"ticket": "二重に請求されています。余分な支払いを返金してください。"},
questions=questions,
)
print(result.choices["team"].choice) # billing
print(result.nouls["refund"].noul) # 返金要求の確率
print(result.scores["urgency"].score) # 緊急度(0〜2)検証環境での出力は次のとおりです(SDK 0.7.2)。
billing
0.9881238296838182
0.9705049446446288
CPUのみで動かす場合は1リクエストに数十秒かかるため、
TypeSafeClient(timeout=600)のようにタイムアウトを長めにしてください。
型付きのChoice / Noul / Scoreクラスで質問を書けるのでエディタの補完が使え、将来Jev(クラウド)とClef(ローカル)を切り替える場合も接続先を変えるだけで済みます。
JavaScript(Node.js)から使う
Node.js 18以降なら、標準のfetchでそのまま呼び出せます。
const res = await fetch("http://localhost:11434/v1/systemone", {
  method: "POST",
  headers: { "Content-Type": "application/json" },
  body: JSON.stringify({
    model: "clef",
    state: "Hello World",
    questions: {
      says_hello: { type: "noul", instructions: "Does the state text contain a greeting?" },
    },
  }),
});
const data = await res.json();
console.log(data.answers.says_hello.noul);
画像を送る
画像はBase64エンコードした文字列をimages配列に入れます。URLやdata:image/png;base64,...形式では送れません。画像を送る場合もstateは必須で、判定の文脈を書いておきます。
import base64
import requests

with open("receipt.png", "rb") as f:
    img = base64.b64encode(f.read()).decode()

res = requests.post(
    "http://localhost:11434/v1/systemone",
    json={
        "model": "clef",
        "state": "添付のレシート画像を経費精算の観点で判定してください。",
        "images": [img],
        "questions": {
            "total_legible": {"type": "noul", "instructions": "合計金額は読み取れますか?"},
            "category": {
                "type": "choice",
                "instructions": "これは何の購入ですか?",
                "criteria": {"meals": "飲食・食事", "travel": "交通・宿泊", "office": "事務用品", "other": None},
            },
            "has_invoice_number": {"type": "noul", "instructions": "インボイス(適格請求書)の登録番号が記載されていますか?"},
        },
    },
    timeout=600,
)
print(res.json()["answers"])
実際に試してみた(検証結果)
ここからは、実際にClefをローカルで動かして判定させた結果です。前半の活用例で紹介した質問をそのまま使っています。
| 項目 | 内容 |
|---|---|
| OS | Windows 10 Pro |
| CPU | AMD Ryzen 5 3600(6コア) |
| メモリ | 96GB |
| Ollama | 0.35.1 |
| モデル | clef(Q4_K_M) |
検証1 問い合わせチケットの振り分け(日本語)
team(choice)・refund(noul)・urgency(score、0=通常 / 1=やや急ぎ / 2=緊急)の3問を同時に判定しました。
| チケット本文 | team | refund | urgency |
|---|---|---|---|
| 先月分の利用料が二重に引き落とされています。余分に支払った分を返金してください。 | billing(0.986) | 0.987 | 0.865(やや急ぎ83.4%) |
| 1時間前から管理画面にログインできず、全店舗でPOSレジが止まっています。至急対応お願いします! | technical(0.940) | 0.008 | 1.926(緊急94.2%) |
| 来年度から50アカウントに増やしたいので、法人プランの見積もりをいただけますか。 | sales(0.974) | 0.007 | 0.058(通常95.1%) |
質問文も選択肢の説明も日本語で書きましたが、3件とも期待どおりに判定されました。「返金してください」と書かれたチケットだけrefundが0.987と高く、それ以外は0.01未満と、はっきり分かれています。
検証2 レビューの満足度スコア
sentiment(score、0=非常に不満 〜4=非常に満足)とmentions_shipping(noul)を判定しました。
| レビュー本文 | sentiment | confidence | 配送への言及 |
|---|---|---|---|
| 音質も装着感も最高。毎日の通勤が楽しみになりました。 | 3.840(非常に満足89.6%) | 0.736 | 0.012 |
| 商品自体は普通。ただ箱が潰れて届いたのは残念。 | 1.522(不満45.7% / 普通43.1%) | 0.330 | 0.976 |
| 3日で壊れた。サポートにも繋がらないし二度と買わない。 | 0.127(非常に不満91.5%) | 0.779 | 0.011 |
2件目は「商品は普通、でも配送は不満」という評価が入り交じったレビューで、「不満」と「普通」に確率が割れ、confidenceも0.330と低くなりました。こうした判断が割れたものだけを人間が確認する運用を、そのまま実現できることがわかります。配送への言及も正しく検出できています。
検証3 レシート画像の判定
次のレシート画像(合計2,673円、インボイス登録番号あり)を送りました。
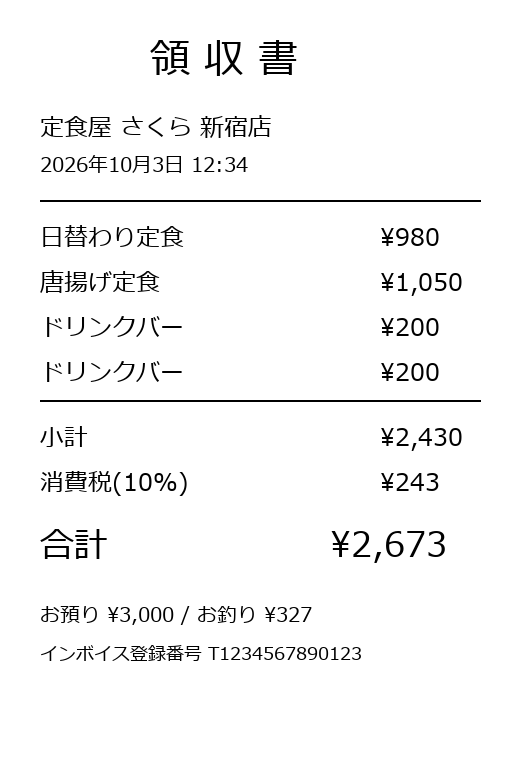
| 質問 | 結果 |
|---|---|
| 合計金額は読み取れますか?(noul) | 0.984 |
| これは何の購入ですか?(choice) | meals(飲食)0.978 |
| インボイスの登録番号が記載されていますか?(noul) | 0.981 |
| 合計金額は3,000円を超えていますか?(noul) | 0.019 |
すべて正解です。特に「3,000円を超えているか」には、合計2,673円を正しく読み取ったうえで0.019(=超えていない)と答えています。金額そのものは返せなくても、判断の形にすれば画像の中の数値も扱えることがわかります。
検証4 申込書の記入漏れチェック
「電話番号(必須)」だけが空欄の申込書と、すべて記入済みの申込書の2枚で比較しました。
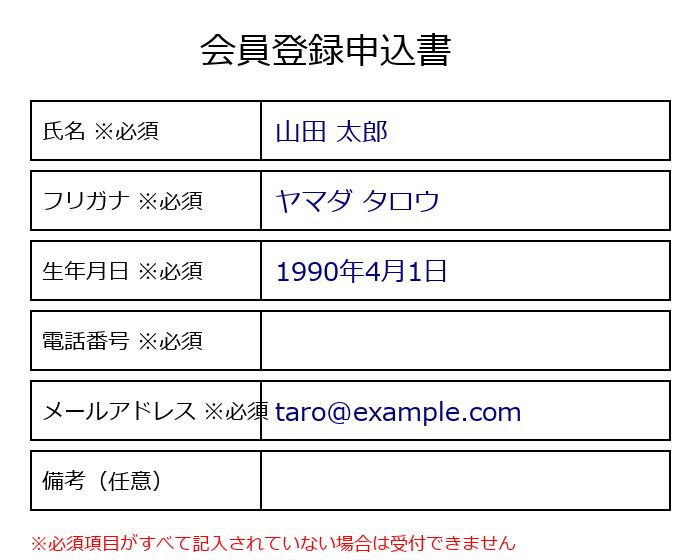
| 画像 | 必須項目はすべて記入済み?(noul) | 書類の種類(choice) |
|---|---|---|
| 電話番号が空欄 | 0.011 | application(申込書)0.933 |
| すべて記入済み | 0.982 | application(申込書)0.942 |
空欄が1か所あるだけで判定がはっきり逆転しており、フォーム送信前のチェックとして十分に使える精度です。
検証5 AIエージェントのツール呼び出しチェック
| ツール呼び出し | harm(noul) | action(choice) |
|---|---|---|
send_email(to="all-customers", subject="【最終通知】本日中にアカウントが停止されます", ...) | 0.987 | block 0.982 |
read_file(path="docs/README.md") | 0.015 | allow 0.954 |
run_shell(command="rm -rf / --no-preserve-root") | 0.988 | block 0.988 |
全顧客への脅し文句のようなメール送信とシステムを破壊するコマンドは「block」、READMEを読むだけの操作は「allow」と、妥当な判定になりました。
検証6 フィッシングメールの判定
差出人が[email protected]、件名が「【重要】お客様のアカウントが一時停止されました」のメールをJSONで渡しました。結果はphishingが0.991、riskが1.963(危険97.3%)でした。
検証7 モデルルーティング
| プロンプト | 判定 |
|---|---|
| 「ありがとう」を英語にして | small 0.994 |
| 決済台帳向けにシャーディングされたデータベーススキーマを設計し、整合性の担保方法も説明して | large 0.993 |
コメント