Qwen

スポンサーリンク
対あり技術部(技術系)

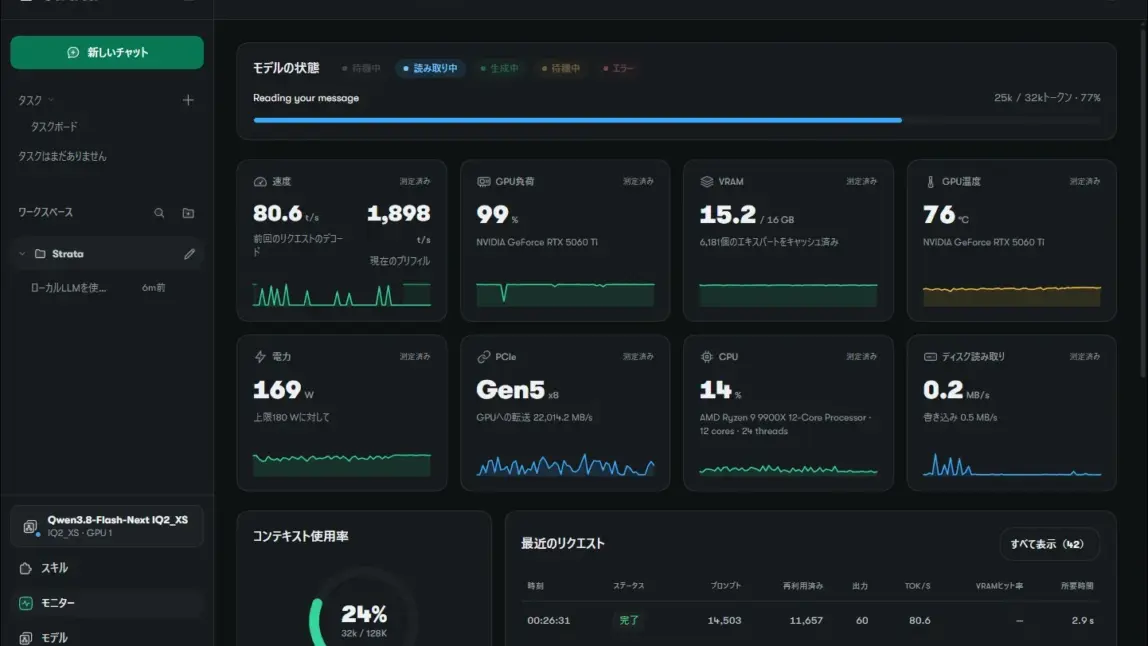
【Strata 0.2.3】アプリ版とターミナル版を検証|RTX 5060 Ti 16GB・128Kで生成が毎秒74→90トークンに

125BのQwen3.8-Flash-Nextを手元のPCで動かすStrataが0.2.3に更新され、Windows用のアプリとターミナル版(strataコマンド)が登場しました。RTX 5060 Ti 16GBとRAM 64GBのPCで、アプリのインストールから日本語表示、ターミナル版のセットアップ画面までを画像付きで紹介し、前回の0.1.43と同じ方法で128Kコンテキストの速度を比較しました。生成は毎秒73.9から90.2トークンに、約12万トークンの読み込みは74.7秒から67.9秒に短縮しています。
対あり技術部(技術系)

Qwen3.8-Flash-Next(検閲なし)をllama.cppでローカル実行する

Qwen3.8-Flash-Nextの検閲なし版モデルをllama.cppでローカル実行する手順を解説します。GGUFファイルのダウンロードからllama-cliでの起動、思考過程の制御やAPIサーバー化までの設定方法をまとめました。
対あり技術部(技術系)

【GPU不要】Qwen3.8-Flash-NextをDDR4メモリだけで動かす

2026年8月26日、AlibabaのQwenチームが「Qwen3.8-Flash-Next」のオープンウェイトを公開しました。次期Qwen4ファミリーで使われる新アーキテクチャの先行公開版という位置づけで、総パラメータ125B(アクティブ...
Blog

Qwen3.8-27B + Ollama でローカルAIを動かす完全ガイド

2026年8月公開のQwen3.8-27Bは、画像・動画対応とエージェント性能が大幅進化。Ollamaでの導入手順、24GB GPUで動かすための要件、Qwen3.6からのベンチマーク向上を解説します。
対あり技術部(技術系)

Qwen3.6:27b MTP を Ollama で動かす完全ガイド

Qwen3.6:27bのMTP対応版「qwen3.6:27b-mtp-q4_K_M」をOllamaでローカル実行する手順を解説。MTP(マルチトークン予測)の仕組みから導入、通常版との速度比較まで実測値付きで紹介します。
対あり技術部(技術系)

Qwen3.6-35B-A3B + Ollama でローカルAIを動かす完全ガイド

Qwen3.6の概要Qwen3.6は、Alibaba CloudのQwenチームが2026年4月にリリースした最新の大規模言語モデル(LLM)シリーズです。Qwen3.5シリーズの好評を受けて、コミュニティからのフィードバックを基に開発され...
Blog

Qwen3.5-Claude-4.6-Opus-Reasoning-Distilled + Ollama でローカルAIを動かす完全ガイド

はじめにQwen3.5-9B-Claude-4.6-Opus-Reasoning-Distilled-GGUF は、Alibaba の Qwen3.5-9B をベースに、Claude 4.6 Opus の推論軌跡を知識蒸留(Knowledg...
スポンサーリンク